SuperGlue 的注意力图神经网络怎样传递信息
本文借 SuperGlue 的两组局部特征,讲清图神经网络如何传递消息、Attention 为什么能选择消息来源,以及自注意力和交叉注意力如何让描述符带上当前图像对的上下文。最后讨论这些关系如何通过匹配监督学出来;最优传输只简述其在系统中的作用。
两幅图像都拍到一排窗户时,一个窗角的局部纹理可能对应好几扇窗。即使描述符提取得很稳定,单独比较两个窗角,也未必能判断它们是否来自同一处。观察整面墙会多出一些线索:这个窗角与门框、屋檐、其他窗户的关系,在另一幅图里能否找到相近的组织方式?
上一篇 SuperGlue 总览从完整的匹配流程出发,介绍了上下文网络和后续的匹配分配。这一篇把镜头移到上下文网络内部。我们关心的具体问题是:一个关键点原本只知道自己的位置和局部外观,网络怎样让它利用两幅图中的其他点,又怎样从最终匹配误差中学会关注哪些点? 这也是理解注意力图神经网络的一条较短路径。
把关键点放到图里
在图神经网络中,节点保存一个随层数变化的特征向量,边规定节点之间可以交换信息。对局部特征匹配来说,每个检测到的关键点都可以成为节点。这里的图与 SfM 的位姿图有共同的“节点—边”组织形式,但更新对象不同:位姿图优化相机状态以减小几何残差;图神经网络沿边传递特征,更新关键点的表示。
先不考虑 SuperGlue 的具体注意力形式。假设节点 在第 层的状态为 ,它从邻居 接收一条由两端状态决定的消息。多条消息聚合后,节点得到新状态:
是节点 在这一层的消息来源, 产生消息, 汇总消息, 则更新节点。聚合常用求和或平均,因为关键点作为集合输入时,调换它们的排列顺序不应该改变匹配问题本身。
这套写法把图神经网络的两个选择分开了:从哪里收集信息由图的边决定,收集到的信息怎样改变节点由消息和更新函数决定。SuperGlue 在两幅图里使用两种消息来源:本图的所有关键点,以及另一幅图的所有关键点。在看这两种边之前,还需要解决一个问题:即使所有点都能提供消息,当前点也不该平均听取每一个点。
Attention 让节点自己选择消息来源
仍看那个有重复窗户的场景。目标窗角附近的另一个窗角可能提供局部排列线索,远处的门框可能提供更醒目的定位线索,大量普通墙面角点的帮助则很有限。若对所有来源直接求平均,有用的消息可能被稀释。Attention 用目标点和来源点当前的状态计算权重,再对来源消息加权求和。
具体做法是把目标节点的状态投影成 Query,把每个来源节点的状态投影成 Key 和 Value:
Query 和 Key 决定这条消息应有多大权重,Value 是真正传给目标节点的内容。令 为 Key 的维数,注意力得分、权重和聚合消息依次为
分母只遍历当前允许通信的来源。除以 是为控制点积的数值尺度;SuperGlue 论文写注意力机制时省略了这一因子,官方实现按每个注意力头的维数进行了缩放。
可以给刚才的窗角构造一个演算用例。假设它面对三个消息来源:一个明显的门框角点、一个邻近窗角和一个普通背景角点。网络在某一层算出的得分若为 ,Softmax 权重大约是 。再假设这三个来源的二维 Value 分别为 、、,那么目标点收到的消息是
这两个维度只是为了手算方便,不代表真实网络中有“门框通道”或“窗户通道”。例子要说明的是:同样有边相连,三个来源对目标点的影响仍可以不同,而且权重会随着节点状态变化。Attention 因此可以直接看成图神经网络的一种加权消息聚合。
为什么要分别学习 与 ?把定义代入得分就能看出,网络计算的是
两个投影矩阵共同决定了哪些特征组合值得比较。这里并没有预先指定欧氏距离或余弦距离;训练会改变这些矩阵,使某些状态组合更容易互相读取。这个双线性打分也不必对称,因而不应把它当作严格的距离度量。Value 使用另一组投影,是因为“根据什么选来源”和“来源提供什么内容”可以由不同特征承担。
标准 Transformer 的自注意力可以理解为一组 Token 在全连接图上按这种方式传消息。经典 GAT 也沿图边分配注意力权重,通常从给定的邻接关系出发。SuperGlue 采用类似 Transformer 的多头点积注意力,特别之处在于它交替切换图像内与图像间的消息来源。
SuperGlue 的两类边分别带来什么
设图像 有 个关键点,图像 有 个。每个点有前端给出的视觉描述符 ,还有二维位置与检测置信度 。SuperGlue 先把后者编码到描述符维度,再相加得到节点初始状态:
视觉描述符提供局部外观;位置和置信度让网络也能利用点在图像中的位置以及检测器对它的判断。位置编码没有直接写出两点的几何约束,它进入节点状态之后,才与其他点的信息一起参加注意力计算。
现在固定图像 中的目标点 ,只改变消息来源:
第一个式子是自注意力:Query 来自 的目标点,Key 和 Value 来自 的所有点。它让那个窗角参考本图的门框、屋檐和其他窗角,形成对自身位置与外观关系的表达。第二个式子是交叉注意力:Query 仍来自 ,Key 和 Value 换成 的所有点。于是 中的窗角开始从另一幅图的候选点群读取信息。图像 中的节点也以同样方式从 读取信息。
这张图的边是稠密的。图内注意力可以连到远处的门框,图间注意力可以查看对侧任何一个候选;每条边实际传递多少信息,再由当前层的注意力权重决定。论文把两类边画在同一套关键点图上,图内和图间的消息传递交替执行。
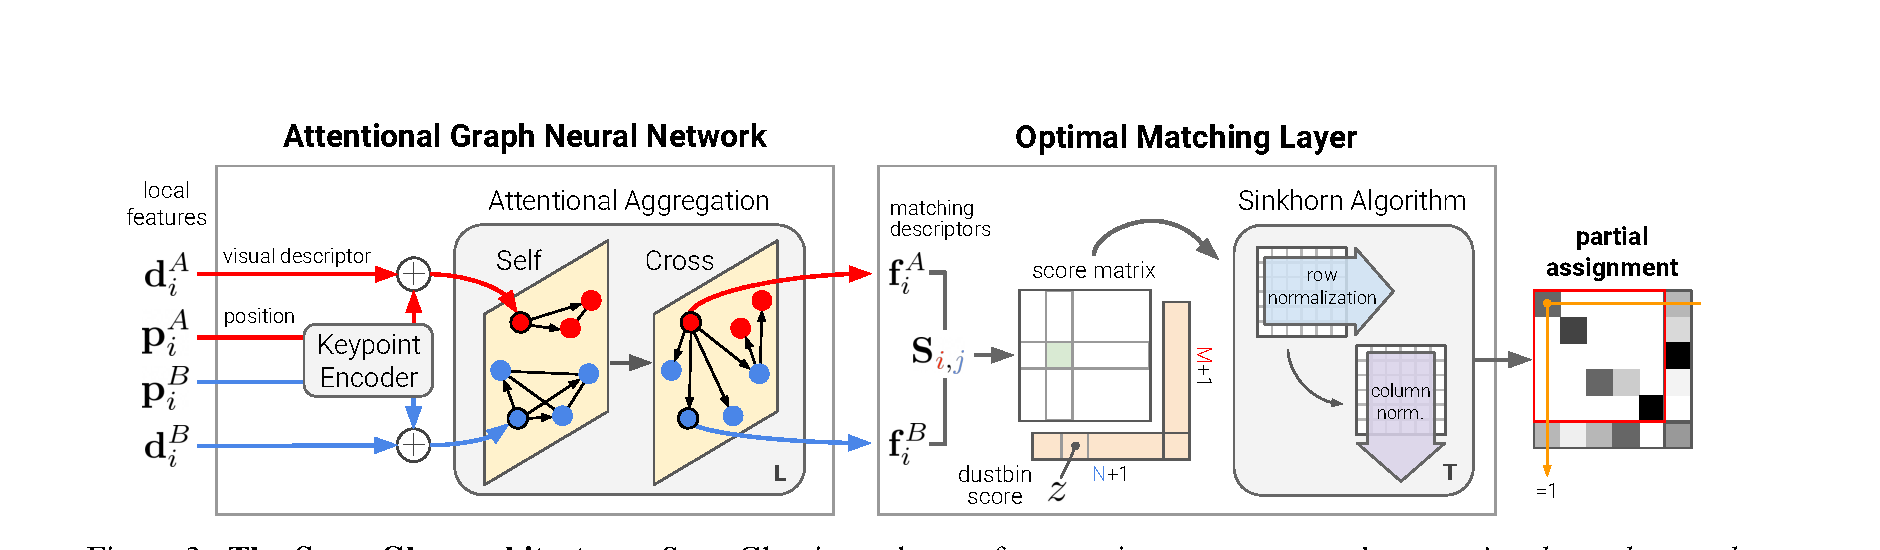
原论文图 3。左侧关键点编码与交替的自注意力、交叉注意力属于本文讨论的图网络;右侧根据网络输出计算匹配分数并形成分配。
图 4 把两种注意力权重画成了连线。上排的连线留在同一幅图内,下排跨越两幅图。阅读时应把连线理解为这一层从哪里读取了特征:一条很深的跨图连线仍不是已经确定的匹配。
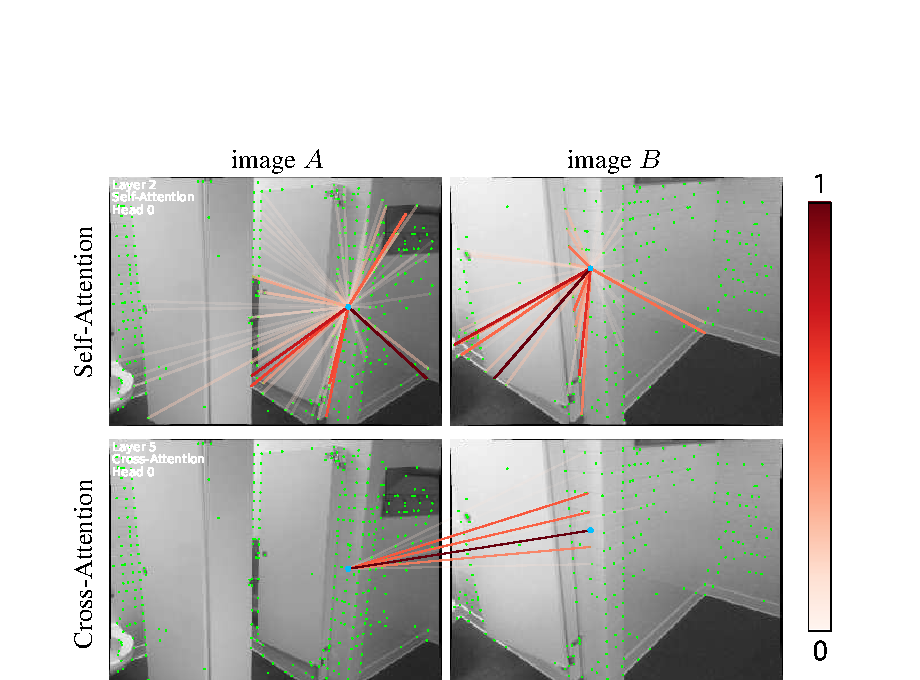
原论文图 4。不同注意力头可以关注近处、远处或对侧的点;图中显示的是聚合权重,而非最终的一对一对应。
交叉注意力还有一个直接后果。图像 的原始局部描述符可以预先算好并缓存;一旦 的节点从 收到了消息,更新后的状态就取决于当前选的是哪一幅 。换一张待匹配图,同一个 点可能得到不同的匹配描述符。这种随图像对变化的表示,是 SuperGlue 与“先固定提特征,再独立做最近邻搜索”的关键差别。
多轮消息怎样回到同一幅图
一次跨图注意力只让某个点直接读到对侧信息。交替堆叠以后,信息可以走更长的路径。例如, 中一个较明确的点先通过交叉注意力影响 中的某个点;下一次自注意力又允许 中其他点从这个更新过的点读取信息。用边类型记,这条路径是 。另一方向同样存在。多轮交替让两组点不断用对方提供的上下文修正自己的表示。
每次聚合后,SuperGlue 把旧状态与收到的消息拼接,交给 MLP 产生更新增量:
拼接使 MLP 同时看到“我原来是什么”和“这次读到了什么”;残差连接把新信息叠加到旧状态上。它更新的是特征向量,并不等同于在位姿图中优化相机运动。论文配置采用 256 维中间状态、4 个注意力头;官方实现交替安排 9 组 self/cross 消息传递,共 18 个注意力阶段。多个头允许网络用不同的投影并行聚合,但没有哪个头被预先规定负责门框、视差或极线。
这一过程也说明了为什么交叉注意力权重不适合直接当成对应关系:此时的任务是交换消息,多个 点可以同时从同一个 点读取信息。网络会在全部交互结束后,再决定具体哪些点配成对。
网络怎样学会该关注谁
前面的演算把三个注意力得分当作已知数,真实网络要从数据中学出它们。SuperGlue 使用由相机位姿与深度,或由单应变换得到的真匹配监督;能够可靠判定为无对应的点也参加训练。网络先生成最终匹配,再根据正确对应获得的分配值计算损失。这个损失可以穿过后续的匹配层、点对分数和多层消息传递,回传到 、、 等参数。
“损失如何改变注意力”可以在一个注意力头里算得更具体。暂时固定来源节点的 Value,记 Softmax 前的得分为 、目标点的聚合消息为 。Softmax 的导数是
把它代入消息的加权和,求出某一个来源得分变化时,消息怎样变化:
这一步有明确含义:提高来源 的得分,相当于让聚合消息朝 移动;若 与当前平均消息 相同,单独提高它的权重也不会改变消息。再令 为后续网络传回的损失梯度,链式法则给出
若右侧为负,提高这个来源的得分会降低当前损失,梯度下降便倾向于提高它;若为正,则倾向于压低它。这个推导只考察单个注意力头的一条聚合路径,完整 SuperGlue 还有残差、MLP、多层交互及其他梯度路径,但它已经解释了注意力权重为什么能够由最终匹配任务来塑造。网络无须预先知道“门框最重要”:它会在具体数据和监督下调整哪些信息值得读取。
位置编码和多轮交互让这种学习有机会利用图像布局与跨图候选,形成对常见场景结构和视角变化的统计经验。它仍没有在注意力层显式求基础矩阵或极线距离;匹配结果进入位姿估计时,几何后端仍能检验它们是否符合相机模型。
有了上下文特征,还要形成匹配
经过最后一层,SuperGlue 把节点状态投影为匹配描述符 、,并计算跨图点对分数:
到这里,图神经网络交出的是一张更有上下文依据的分数表。某个点可以给多个候选打高分,也可能根本没有对应。后续匹配层会加入“无匹配”选项,用带 Sinkhorn 迭代的最优传输,在行列约束下形成软分配。它处理的是候选点对之间的整体竞争;Attention 的 Softmax 则只决定某个节点在当前层怎样聚合消息。两者都会计算权重,但权重承担的任务不同。
这种分工也带来计算代价。若两幅图分别有 、 个点,一轮图内注意力要考察约 个点对,双向跨图注意力要考察约 个点对。更重要的是,交叉注意力后的描述符依赖待匹配的图像对,不能像前端局部描述符一样为每幅图只算一次、到处复用。上下文匹配的收益和这部分逐对计算的成本,在 SfM 或 SLAM 系统中需要一起考虑。
回到开头的窗户:局部描述符给出了初始外观,图内消息让窗角带上本图的结构线索,跨图消息让它结合另一幅图的候选;训练用最终对应的误差调整“该读谁、读到什么”。SuperGlue 中的图神经网络就是这条特征更新链。它帮助后面的分配层拿到更有辨识度的分数,而最优传输负责把这些分数组织成允许拒配的对应关系。
参考资料
- P.-E. Sarlin, D. DeTone, T. Malisiewicz, and A. Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks(论文 HTML,PDF). CVPR, 2020.
- 作者公开的 SuperGlue PyTorch 实现。