SuperGlue:注意力与最优传输如何完成局部特征匹配
本文介绍 Paul-Edouard Sarlin、Daniel DeTone、Tomasz Malisiewicz 和 Andrew Rabinovich 在 CVPR 2020 的工作 SuperGlue: Learning Feature Matching with Graph Neural Networks。文章沿着“局部描述符的歧义 → 图内与图间的信息交换 → 允许无匹配点的部分分配 → Sinkhorn 训练与位姿实验”展开,并对 dustbin 的质量约束作具体推导。
两幅图像都拍到同一栋楼的一排窗户时,每个窗角的局部图像块都很相似。即使特征描述符足够稳定,也可能无法独立判断某个窗角对应哪一扇窗。场景边缘还会出现只在一幅图中可见的点,它们没有真实对应,最近邻搜索却总能找到一个“最相似”的候选。
经典匹配流程通常先独立提取两幅图的局部特征,再做最近邻搜索,接着用互检、比值检验或学习型内点分类器删除可疑匹配,最后用 RANSAC 估计几何关系。这个流程能降低误匹配,但一旦真实对应点没有进入最近邻结果,后续过滤很难把它找回来。互检还主要检查双方是否相互偏好,无法利用图中其他点提供的上下文。
SuperGlue 的切入点是学习匹配过程本身。它接收前端已经提取的关键点和描述符,让点在同一幅图以及两幅图之间交换信息,然后对所有候选点对评分,最后在整张评分矩阵上求一个满足容量约束的分配。作者因此把它放在局部特征前端与位姿估计后端之间,称为可学习的 middle-end。它不负责重新检测关键点,也不直接输出相机位姿。
这条链路有两个互相依赖的问题。注意力网络要回答“面对当前两幅图,这一对点到底有多可信”;最优匹配层要回答“所有被认为可信的点对能否同时成立”。前者让描述符利用上下文,后者要求每个点至多参与一条真实匹配,并允许点没有对应。两者的输入、输出和约束可以先在同一张图里看清。
图中前半段生成匹配分数,后半段形成部分分配。图内、图间注意力对分数的作用与 Sinkhorn 对整张表的作用不同;如果只保留其中一半,分别会失去上下文消歧或整体约束。
1. 为什么匹配不能只看最近邻
先看一个不涉及神经网络的小例子。图像 中有 两个点,图像 中有 两个点。假设它们的局部相似度如下,数值仅用于说明分配结构,并非论文实验数据:
| 相似度 | ||
|---|---|---|
| 0.91 | 0.90 | |
| 0.89 | 0.20 |
逐行选最大值时, 和 都选 。互检会保留 ,却丢掉 。如果要求两对匹配共同成立,那么 与 的分数和为 ;另一种一对一组合的分数和只有 。 对 只是第二近邻,放到整张表里却参与了更合理的组合。
这个例子仅说明独立选择与联合分配会得到不同结果。真实图像中还需要判断分数本身是否可靠。例如,重复窗户的多个候选都可能很相似,而一个被遮挡点面对的所有候选都可能是错的。因此,SuperGlue 一方面通过上下文改变这些分数,另一方面给“无匹配”保留出口。
令图像 有 个关键点、图像 有 个关键点。每个点的输入由位置、检测置信度和视觉描述符组成:
最终的软匹配矩阵 需要满足原文式(1):
第一条限制每个 点在所有 点上的总匹配质量,第二条限制每个 点被所有 点占用的总质量。小于号使两侧的点都可以没有对应。若只对每一行做 softmax,行和会被强制为一,也没有列方向的容量竞争;它无法直接产生原文定义的部分分配。
这一表述说明论文并不是在最后简单“选几个最高分”。分数来自网络,分配则是带约束的优化问题。下面先看网络如何让分数包含两张图的结构信息。
2. 两张图中的关键点怎样交换信息
2.1 位置进入描述符,但不直接充当几何解
输入的视觉描述符 通常来自单幅图像。它概括点附近的外观,却不知当前要与哪幅图匹配。SuperGlue 将位置和检测置信度经过一个 MLP 编码,再加到视觉描述符上:
是注意力网络中的初始点状态。坐标使网络可以比较点群布局;置信度使检测器对该点可靠性的判断也进入后续计算。这个加法并没有产生相机位姿或极线方程,它只是让网络在处理外观时不丢掉位置证据。
论文把两组点放在一张具有两类边的图中。同一幅图里的点彼此通过 self edge 相连;不同图像的点通过 cross edge 相连。self edge 对应自注意力,允许一个点查看本图的其他点;cross edge 对应交叉注意力,允许它查看另一幅图的候选。两类边都覆盖相应集合中的全部关键点,不预设一个固定的局部邻域。
这里的“图神经网络”可以按消息传递来理解:节点保存点状态,边决定本层可以从哪里收集消息。不同于需要先构建三维场景图的做法,这张图直接由两组已检测的二维关键点构成。
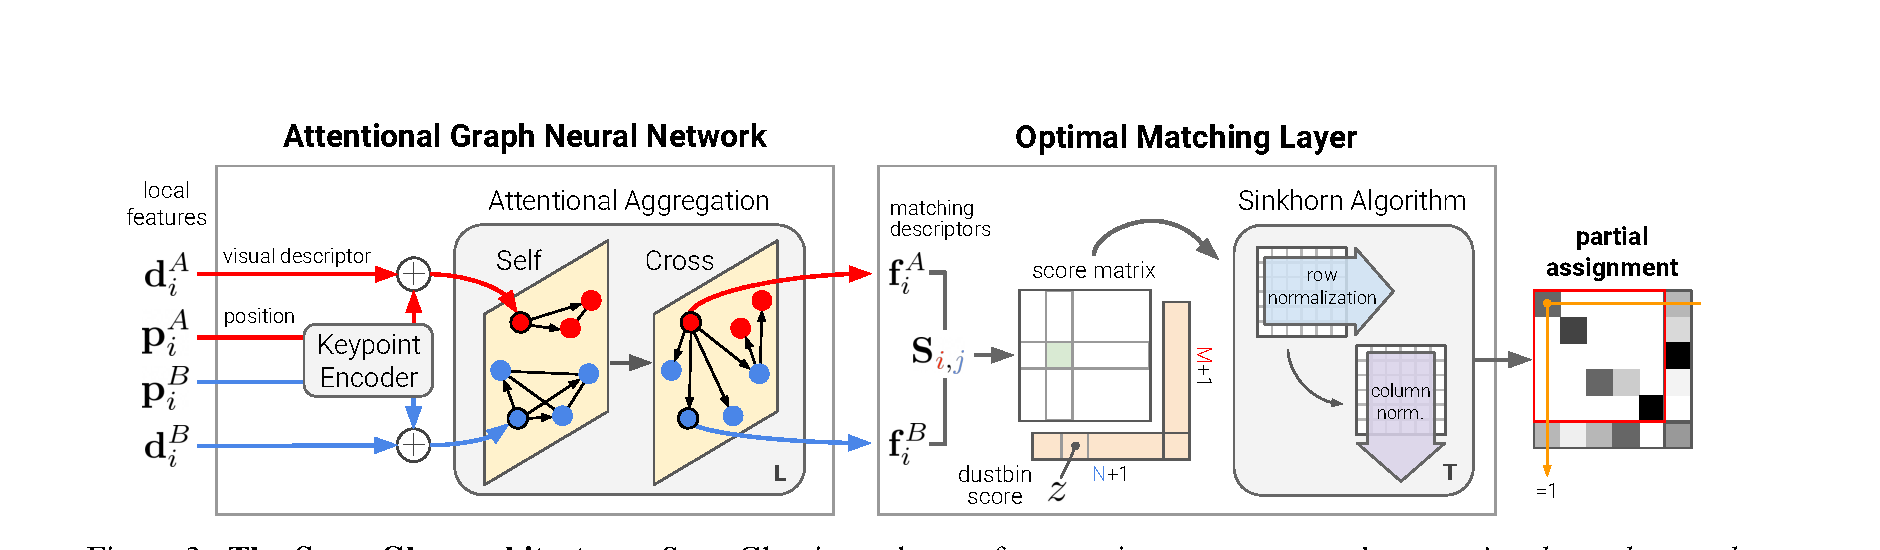
原论文图 3。左侧交替进行图内自注意力和图间交叉注意力,生成依赖图像对的匹配描述符;右侧计算点对分数、加入 dustbin,再通过 Sinkhorn 迭代得到部分分配。图中 分别表示两幅图中的关键点数。
2.2 自注意力与交叉注意力承担不同的工作
给定目标点 和当前边类型 ,其消息是连接到它的来源点的加权和:
查询 来自目标点的当前状态,键 与值 来自来源点的当前状态,三者都由可学习的线性投影产生。权重 决定“这一层从哪个点接收多少信息”;它不是最终的匹配概率。自注意力层中,来源点与目标点位于同一幅图;交叉注意力层中,来源点位于另一幅图。
仍以窗户为例。图内注意力可能让窗角看到门框、屋檐或者其他窗角的相对布局,使两个外观相似的窗角获得不同状态。图间注意力又使它查看另一幅图中哪些点与当前状态相容,以及图中较明确的候选能提供什么线索。下一轮图内注意力继续利用更新过的状态。多轮往返让“这个点长什么样”逐步变成“这个点在当前两幅图的关系中扮演什么角色”。这是一种理解网络能力的例子,论文没有为窗户、门框设立显式检测规则。
每层把收到的消息与原状态拼接,再做残差更新。原文式(3)可写成:
奇数层使用图内边、偶数层使用图间边,两幅图对称地处理。残差保留了已有点状态,也让后续层能够叠加新的上下文。原论文使用多头注意力,使不同头可以关注不同的点群关系;展示的注意力图中,有的头关注近邻,有的头关注显著或相似的远处点。
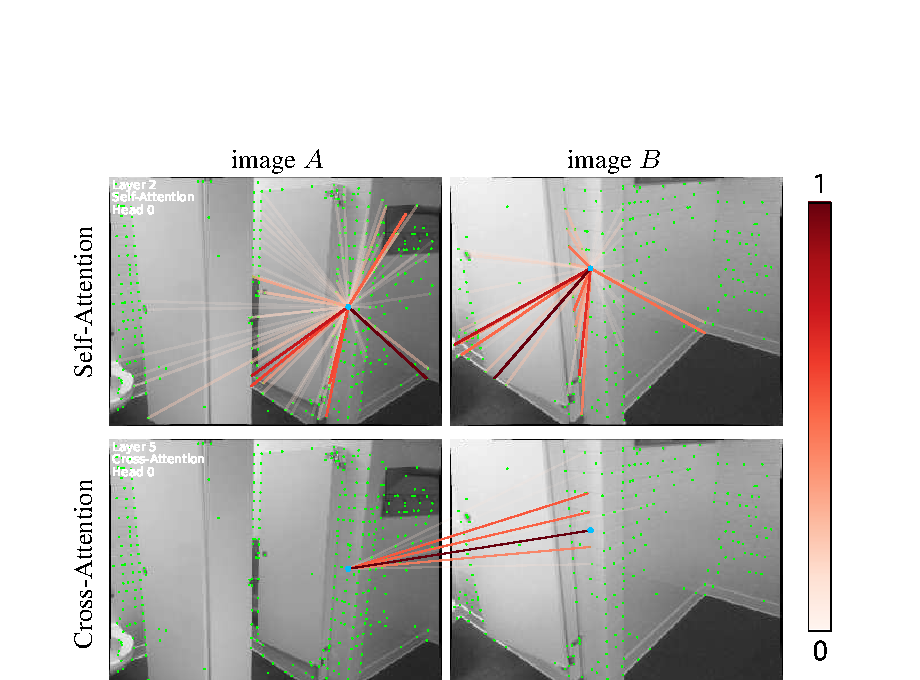
原论文图 4。上排显示同一幅图内部的自注意力,下排显示从一幅图指向另一幅图的交叉注意力;连线颜色越深,表示该注意力头分配的权重越高。
经过 层后,网络线性投影得到匹配描述符:
需要区分 与 。 是前端在单张图中生成的局部视觉描述符; 经过两张图间的交叉注意力,依赖当前待匹配的图像对。同一个 点更换另一张待匹配图时,输入描述符可以不变,最终 却可能改变。SuperGlue 的匹配能力很大一部分来自这种条件化表示。
2.3 几何规律从哪里进入
真实对应点是同一三维点在两幅图中的投影。静态场景下,同一图像对的匹配还受到共同相机运动约束。SuperGlue 没有显式求解这些几何量再回头修正描述符;它将二维位置放入点状态,让图内、图间注意力学习哪些空间与外观关系有助于对应判断,再用几何真值构造监督。论文所说的“学习三维世界与几何变换的先验”应按这条链路理解。
这也限定了它的保证范围。网络可能学到对某些视角、结构和训练分布有效的关系,但注意力权重本身不是基础矩阵或位姿估计。即使匹配满足一对一约束,也不意味着所有点对已经通过了同一个极线几何检验。
3. 无匹配点怎样进入分配问题
有了 和 ,SuperGlue 用内积计算所有候选点对的分数:
论文没有将这些匹配描述符归一化到单位长度,因此向量模长也可以影响匹配分数。 是尚未施加一对一约束的评分矩阵;每个点对是否被保留,还要看它与其他点对以及“无匹配”选项如何竞争。
SuperGlue 给 加一列和一行,形成 的扩展矩阵 。右侧一列供 中的点选择“在 中没有对应”;下方一行供 中的点选择“在 中没有对应”。新增分数统一设为一个可学习量 ,包括右下角:
这两处扩展称为 dustbin。它们不是两个普通关键点,因为一次遮挡可能让许多点同时无法匹配。论文给扩展分配 指定如下行、列质量:
每个真实点仍只拥有或需要一个单位的质量;附加行和列分别有 与 单位的容量。两边质量总量同为 ,因此运输问题可以同时满足全部行与列。 和 是容量设计,不是网络预测的遮挡点数量。
右下角为什么也需要分数,可以直接算出来。设真实点之间的总匹配质量为 。普通 行一共具有 单位质量,其中 流向真实 列,所以剩下 流向右侧 dustbin。普通 列需要 单位质量,其中 来自真实 行,所以还需要下方 dustbin 提供 。下方 dustbin 的行和必须是 ,因而右下角必须取
若分配是离散的, 就是真实匹配的对数;若分配是软的, 是总匹配质量。右下角没有表达一条真实匹配,它只是使两侧无匹配出口的质量守恒。删去扩展行列后,左上角的 恰好允许行和、列和小于一,这就是式(1)的部分分配。
4. Sinkhorn 如何把分数变成软分配
现在有了点对分数 ,也有必须满足的行列质量 。若直接求一个离散的最大权分配,输出会因候选选择而跳变,不便于从匹配监督反向更新前面的网络。SuperGlue 使用熵正则的最优传输,让分配在训练时保持连续。
为了看清求解对象,可以把原文讨论的熵正则问题写为
其中 。第一项让高分点对获得更多质量;第二项使解保持软值。 的尺度可以吸收到分数中。令 ,最优传输的缩放形式为 。为了使行和、列和分别达到 ,交替更新:
表示逐元素相除。调好行后,列和可能仍不对;调好列后,行和又会变化,于是反复迭代。有限次迭代得到的是对目标边缘质量的近似满足。论文配置使用 100 次迭代,最后删去 dustbin 行列,保留真实点之间的软分配 。
这里有两种不同的“竞争”。注意力阶段,一个点选择从哪些点接收信息,改变自身的匹配描述符;Sinkhorn 阶段,候选点对在行列容量中竞争,改变最终的匹配质量。前者决定分数是否看懂了上下文,后者决定高分候选能否同时成立。论文将 Sinkhorn 称为可微的 Hungarian 算法;更精确地说,它求得的是熵正则化后的软分配,并非直接返回离散的 Hungarian 解。
5. 训练信号与模型规模
训练时需要同时教会网络“配对”与“拒配”。在已知单应变换的图像对上,可以直接把关键点映射到另一张图;在有相机位姿和深度的场景中,可以利用三维重投影构造真值。令 是可靠对应点集合, 与 分别是两幅图中可靠判定为无对应的关键点集合。论文式(10)的损失为
真匹配被推向真实点对单元,无匹配点被推向相应 dustbin。这样,“拒绝某个点”不是推理末端补上的启发式规则,而是训练目标的一部分。注意力、点对评分与 Sinkhorn 都可微,因此一个错误的最终分配能够反向改变前面产生分数的方式。
论文实验常把 SuperGlue 与 SuperPoint 结合。SuperPoint 的描述符从半稠密特征图双线性采样;为比较匹配器本身,作者通常固定这个描述符前端,只训练 SuperGlue。模型中间维度为 256,使用总共 9 层交替的自注意力与交叉注意力、每层 4 个头,以及 100 次 Sinkhorn 迭代。推理时可以使用置信度阈值筛出匹配,论文给出的阈值是 ,也可以把软分配置信度交给后续加权位姿估计。
两个阶段都要处理大量点之间的关系。图内注意力涉及约 个点对,图间注意力、评分矩阵与每次 Sinkhorn 迭代涉及约 个点对。因此,关键点数量直接影响计算和显存。论文报告 1200 万参数,在 GTX 1080 上处理其室内图像对平均约 ;该数值取决于硬件、点数和实现,不能视作方法恒定的速度。
6. 实验中分别验证了什么
6.1 单应性估计检验找回匹配的能力
作者用真实图像经随机单应变换和光度扰动形成图像对。已知变换使匹配精度、召回率及角点重投影误差都能计算。所有比较方法使用 SuperPoint 特征,因此结果主要反映匹配器的差别。最近邻互检、PointCN 和 OANet 等方法提供了从手工过滤到学习型内点分类的参照。
原文 Table 1 中,最近邻互检的匹配精度为 、召回率为 ;SuperGlue 分别为 和 。这里尤其值得看召回率:一个只在最近邻匹配里判内外点的模型,很难恢复未进入候选集合的真实对应;SuperGlue 从全部点对构建评分矩阵,因而有机会找回它们。
同一实验还分别用 RANSAC 和直接线性变换 DLT 估计单应矩阵,以图像四角的平均重投影误差统计 10 像素阈值内的 AUC。SuperGlue 对应的 AUC 分别为 与 ,DLT 在这组受控数据上反而更高。这说明输出点对在该实验中较干净,不意味着所有真实三维场景都可以舍弃鲁棒几何估计。
6.2 室内外位姿检验匹配能否服务后端
室内实验使用 ScanNet。作者依据位姿和深度计算图像重叠,选取较难的宽基线图像对。匹配之后仍使用本质矩阵估计与 RANSAC 求相对位姿;位姿误差取旋转角误差与平移方向角误差中的较大值,并统计在 5°、10°、20° 阈值内的 AUC。这个设计检验的是匹配质量能否改善几何估计,而不是让 SuperGlue 取代后端。
Table 2 的部分结果如下。前三行固定了 SuperPoint 前端,可以直接比较不同匹配器;第四行说明它也能使用 SIFT,不能与前面三行直接归因为同一前端上的匹配器差异。
| 局部特征与匹配器 | ScanNet AUC@20° | 匹配精度 |
|---|---|---|
| SuperPoint + 最近邻互检 | 36.40 | 50.4% |
| SuperPoint + OANet | 43.85 | 74.0% |
| SuperPoint + SuperGlue | 51.84 | 84.4% |
| SIFT + SuperGlue | 28.67 | 74.2% |
室外实验使用 PhotoTourism,学习型方法在 MegaDepth 上训练,并从训练中去除测试场景。Table 3 中,SuperPoint + SuperGlue 的 AUC@20° 为 ,匹配精度为 ;SuperPoint + OANet 的 AUC@20° 为 。SIFT 搭配 SuperGlue 时也优于表中的 SIFT 匹配基线。室内外证据共同支持这种中间层能够搭配不同类型的局部特征,但增益大小仍依赖图像对和评估协议。
原论文的图 5 把室内与室外的位姿结果画在同一张图中。柱高是 AUC@20°;颜色区分 SIFT 与 SuperPoint 前端,因此应先在同一种前端内比较匹配器。两组中 SuperGlue 都高于相应的最近邻和 OANet 基线。
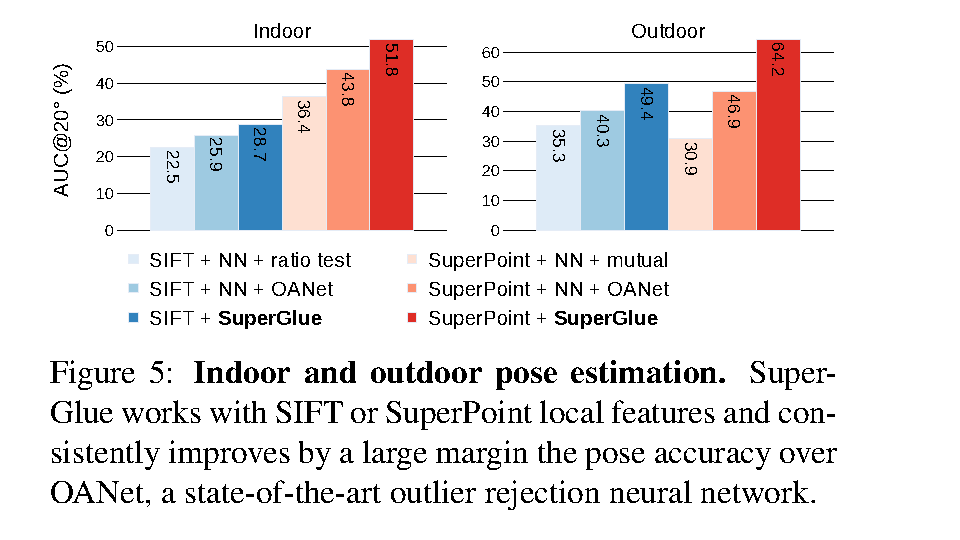
原论文图 5。纵轴为 AUC@20°,分别比较 ScanNet 室内场景与 PhotoTourism 室外场景中的局部特征和匹配器组合。
定量指标概括整体趋势,原论文图 6 展示了具体图像对上的匹配分布。绿色线表示正确匹配,红色线表示错误匹配;三列依次为最近邻加距离阈值、最近邻加 OANet、SuperPoint 加 SuperGlue。可以看到 SuperGlue 在不少室内外例子中保留了更多正确对应,但仍会出现错误连线,所以它的输出仍需要下游几何估计验证。
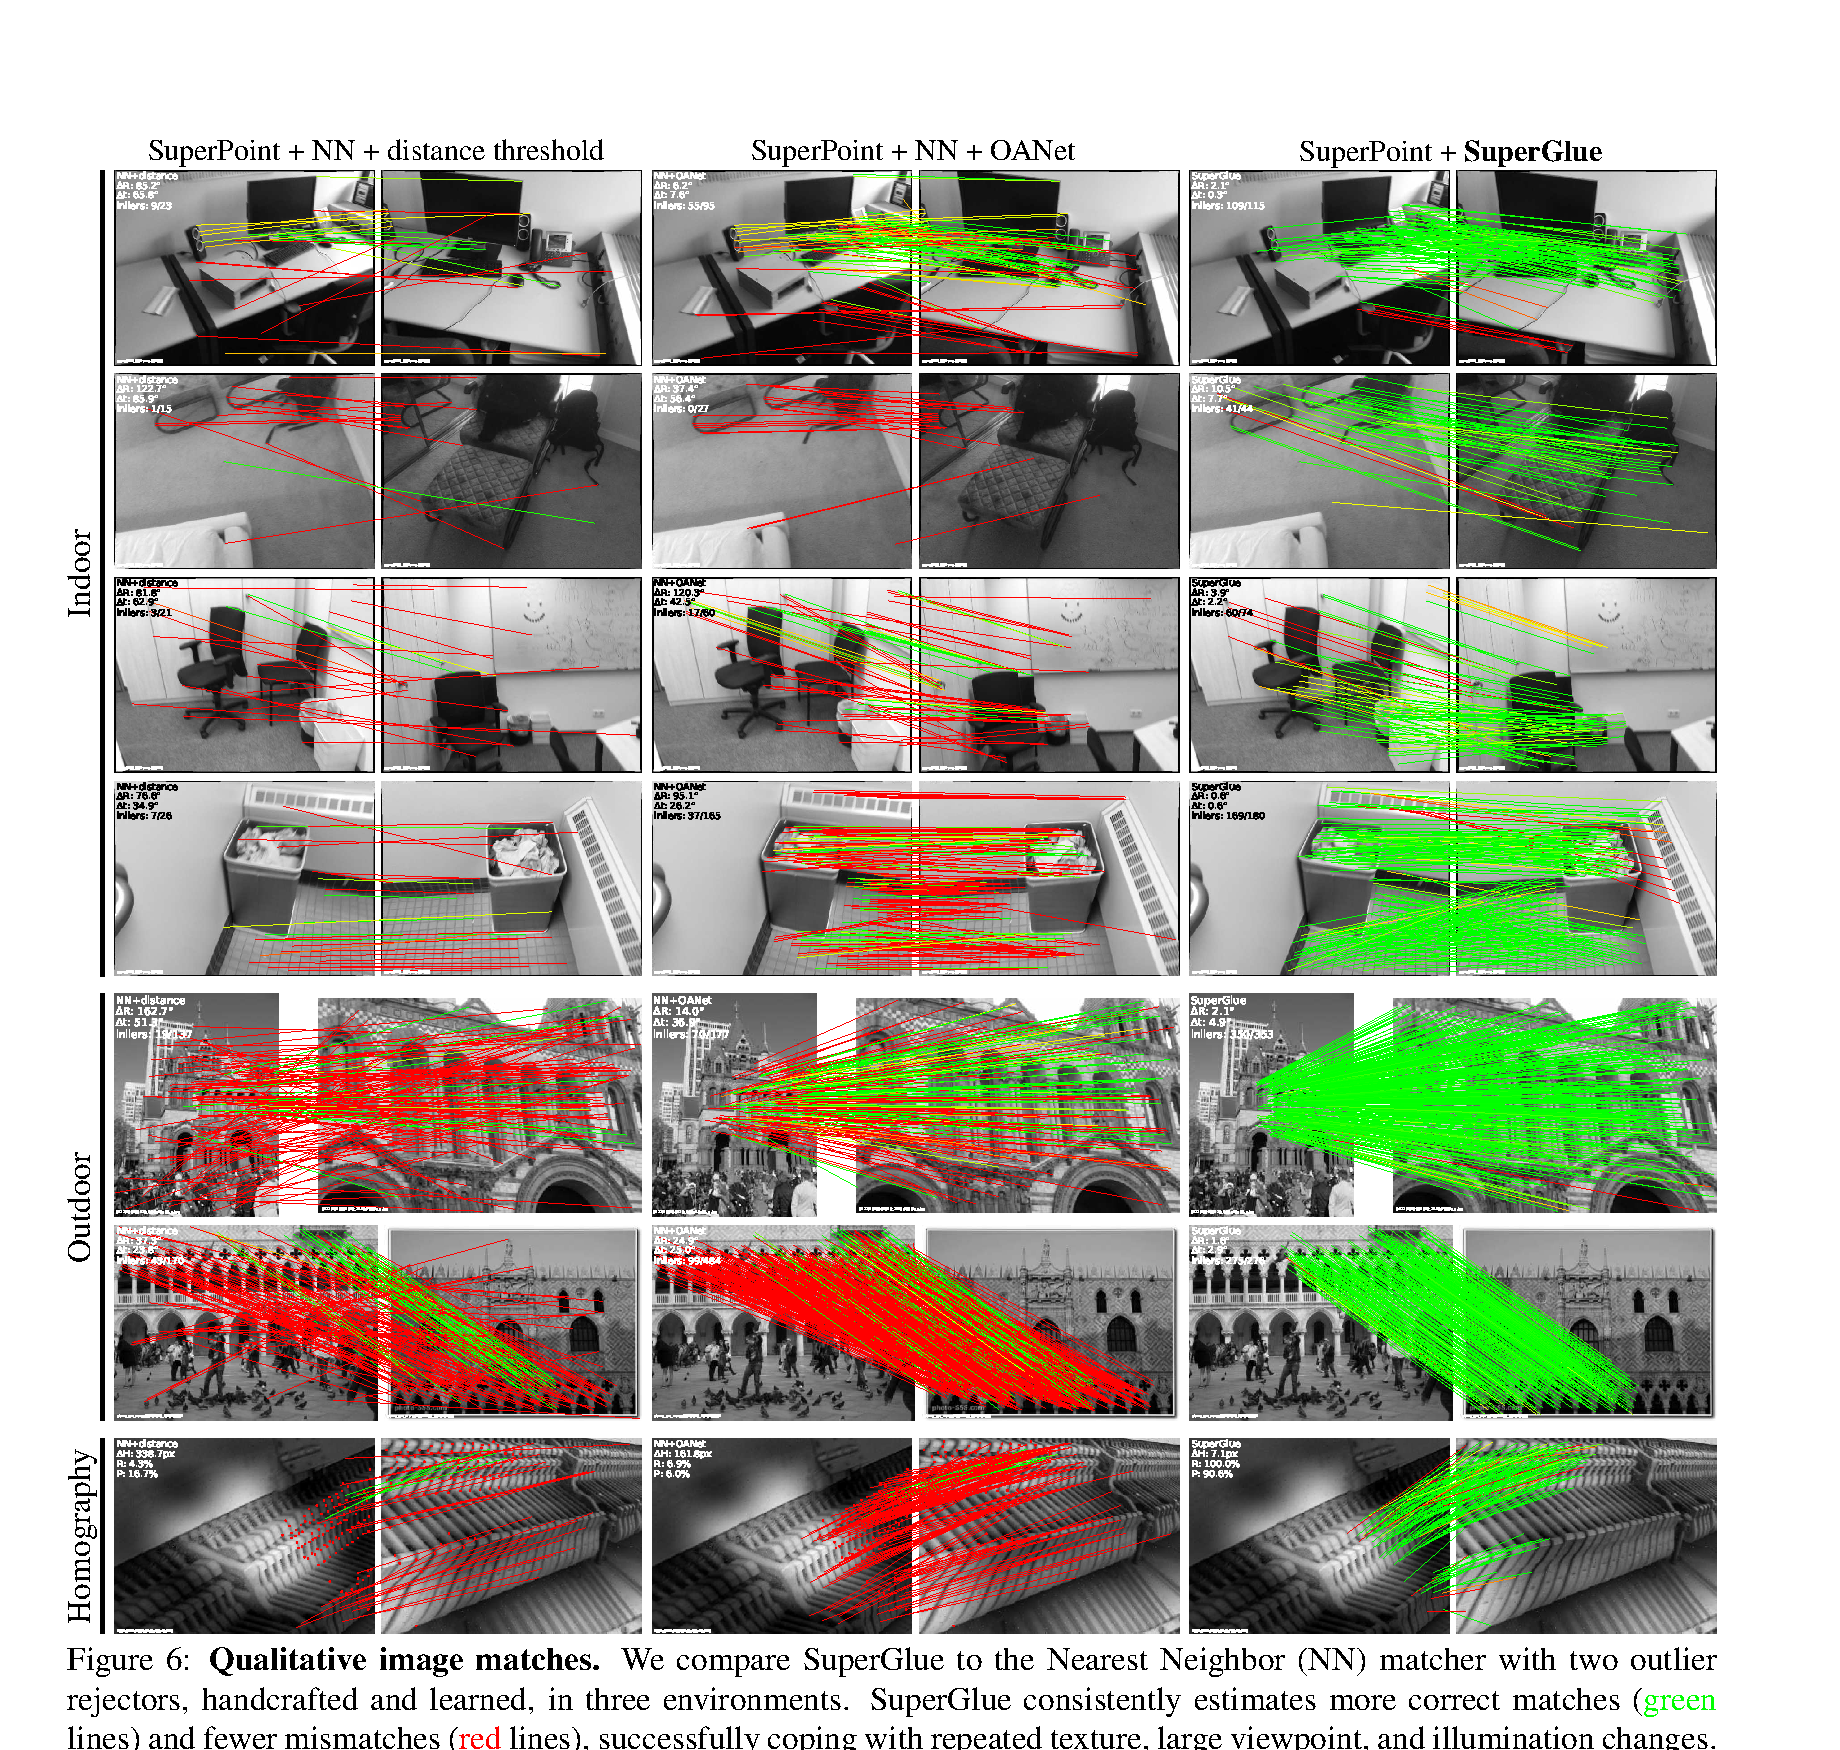
原论文图 6。绿色表示正确匹配,红色表示错误匹配;行分别展示室内、室外和单应性场景。
6.3 消融实验检验上下文和分配各自的贡献
Table 4 在同一室内 SuperPoint 设置下逐个拿掉模块,比单纯比较完整模型更能说明论文思想:
| 方法 | AUC@20° | 匹配精度 |
|---|---|---|
| 最近邻互检 | 36.40 | 50.4% |
| 无图神经网络,仅保留最优匹配层 | 38.56 | 66.0% |
| 去掉交叉注意力 | 42.57 | 74.0% |
| 去掉位置编码 | 47.12 | 75.8% |
| 缩至 3 层 | 46.93 | 79.9% |
| 完整 9 层 SuperGlue | 51.84 | 84.4% |
仅保留最优匹配层,精度有提升,位姿 AUC 却只从 到 。加入上下文网络后才出现主要增益;去掉跨图通信或位置编码,性能又下降。一对一约束可以减少候选冲突,但它无法凭空认出重复纹理中的正确点。上下文改善评分之后,分配约束才能在更好的候选之间发挥作用。
论文还报告,若训练时继续对 SuperPoint 描述符网络反向传播,室内 AUC@20° 从 提高到 。这说明中间层与前端可以联合优化;主表中的比较通常固定描述符前端,不能把额外联训带来的收益算作基础匹配器的效果。
7. 方法关系与适用范围
SuperGlue 可以看成把传统流水线里的三个动作连接起来:利用上下文重新表达局部特征,给全部候选点对打分,在整体容量约束下同时决定匹配和拒配。它比“描述符最近邻 + 内点过滤”多出的能力,主要是对当前图像对重新组织候选,而不是只对固定候选做二分类。论文消融也表明,单有分配约束或单有局部相似度都不足以复现完整效果。
这项能力仍依赖前端检测到可重复的关键点。若同一个物理位置只在一幅图中出现,匹配器无法创造缺失的另一端,只能把这个点送入 dustbin。注意力学到的几何先验也不是一条显式极线约束:输出满足软的一对一结构,却不能保证所有点对都符合某个相机运动。因此,真实位姿实验在 SuperGlue 之后仍使用 RANSAC。
论文实验还提醒我们区分三个指标。匹配精度衡量输出中有多少是对的;召回率衡量本可找到的真对应是否被找回;位姿 AUC衡量这些匹配最终是否帮助几何估计。单应性实验突出找回能力,室内外实验检验下游位姿,消融实验说明这些收益来自哪里。把三类证据连起来,才能判断网络是否真正改善了数据关联。
SuperGlue 的核心认识是:局部描述符只提供匹配的初始线索,点的身份还可以由图内结构与另一幅图中的候选共同决定;单个点对的高分也不足以成为最终答案,它还必须与其他点对及无匹配选择共存。注意力解决前一个问题,带 dustbin 的最优传输解决后一个问题。两者协同,构成了这篇论文所说的可学习匹配中间层。
参考资料
- P.-E. Sarlin, D. DeTone, T. Malisiewicz, and A. Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks(PDF). CVPR, 2020. 文中的模型、参数和实验数据均依据该论文;两点相似度示例及 dustbin 质量推导用于解释原文机制。